RAINWALKERWEEKLY008
24—30 AUGUST 2026
比播放
更快
五秒画面开始在三秒内返回,三十秒成片与四十秒延展同周落地。速度改写了制作节奏,连续性、声音和信任也被推到镜头前。
LONGERFASTERCONTROLTRUST
ORIGINAL ARTWORK · RAINWALKER WEEKLY · 2026
24—30 AUGUST 2026
五秒画面开始在三秒内返回,三十秒成片与四十秒延展同周落地。速度改写了制作节奏,连续性、声音和信任也被推到镜头前。
ORIGINAL ARTWORK · RAINWALKER WEEKLY · 2026
EDITOR'S NOTE
过去做 AI 视频,先要学会等。等队列,等短片,等失败后再抽一次。本周几次发布把等待压得很短:五秒画面可以在三秒内返回,草稿便宜到适合连续试,场景也能从十秒一路接到四十秒。
这并没有让电影自动完成。它只把导演、剪辑和观众拉得更近。人可以趁着一个念头还热,立刻看见下一版。本期从速度出发,也看看连续性、声音授权和公众信任如何跟上。
THE WEEK, EDITED
按公开发布日排列。排行榜与播放量为截稿时快照。
最长三十秒,支持文档、表格、幻灯片和网页输入。
官方发布 ↗逐段生成的访谈视频,用测量、修复和锁定维持同步。
工程报告 ↗儿童角色、授权 IP 和实时对话进入同一套生意。
公司公告 ↗十五分钟连续动画,让 AI 影像离一次性短片又远了一步。
完整作品 ↗延展、首尾帧、低清草稿、视频参考与 4K 放大同时更新。
Google 官方说明 ↗SIX READS
后面四十四页交代过程、限制和可以动手的地方。
THE LONGER SHOT
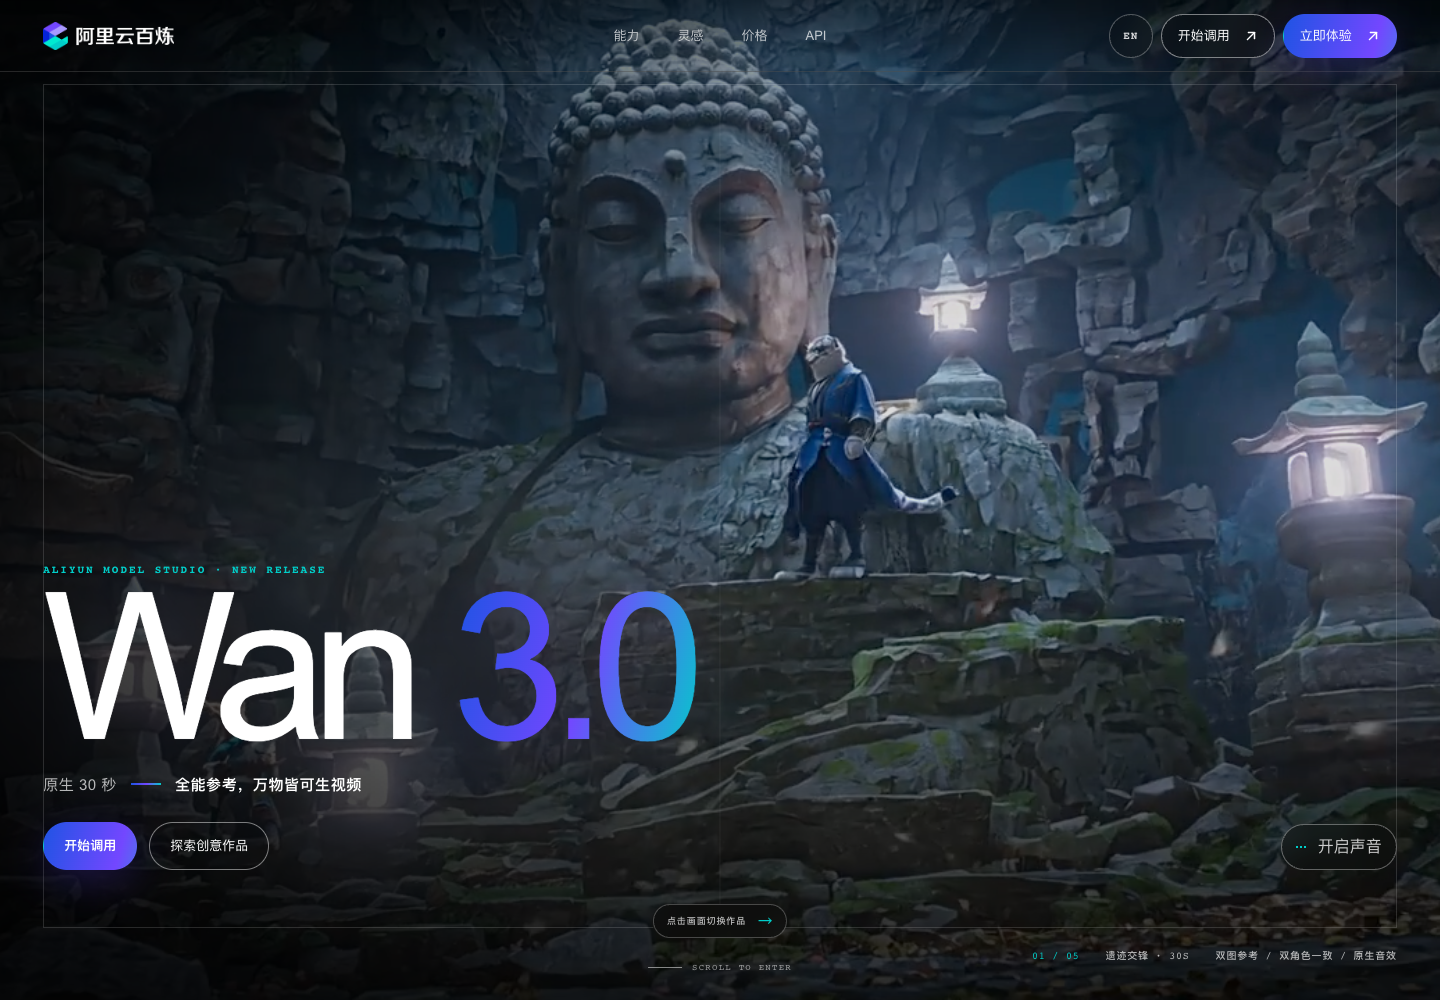
阿里云 8 月 24 日开放 Wan 3.0。官方列出的重点包括最长三十秒、1080p、原生音画,以及更丰富的输入材料。
三十秒不等于三十秒都可直接交片。它先解决的是镜头被硬切得太碎:人物走进房间、完成动作、说完一句话,可以留在同一次生成里。
阿里云官方发布 ↗THE NUMBER
一句话可以留下停顿和反应,不必每个口型都另起一条。
入画、移动、转身和离场有机会在同一空间里完成。
原生音画减少后期寻找环境声和临时配音的次数。
BEYOND THE PROMPT BOX
Wan 3.0 的产品页面把多种办公文件列为输入。它瞄准的不只是写提示词的人,也包括拿着脚本、产品资料和提案开工的团队。
提取人物、动作、场景和叙事顺序。
把结构化字段转成批量视频任务。
保留页面次序,生成可观看的演示草稿。
读取公开页面中的文字和视觉线索。
文件输入省的是搬运时间。资料能否被正确理解,仍要靠人检查。输入类型说明 ↗
THE COST OF A TRY
公开报道列出的中国区价格按秒计费。8 月 24 日至 9 月 23 日有七折活动,下面先用原价比较。
三十秒约 ¥9
三十秒约 ¥18
三十秒约 ¥36
动作和构图先用低分辨率确认;只有入选镜头再做 1080p。十次无差别高清重抽,价格很快超过一次精心准备的拍摄。
DISTRIBUTION MATTERS
Runway 8 月 24 日把 Wan 3.0 加进 Tool Mode 与 Workflows。创作者不用离开现有项目,就能把它和其他模型、素材及自动步骤接起来。
模型竞争之外,入口也在竞争。哪个工具能留住脚本、参考图、版本和批准记录,哪个工具就更接近日常制作。
Runway 更新日志 ↗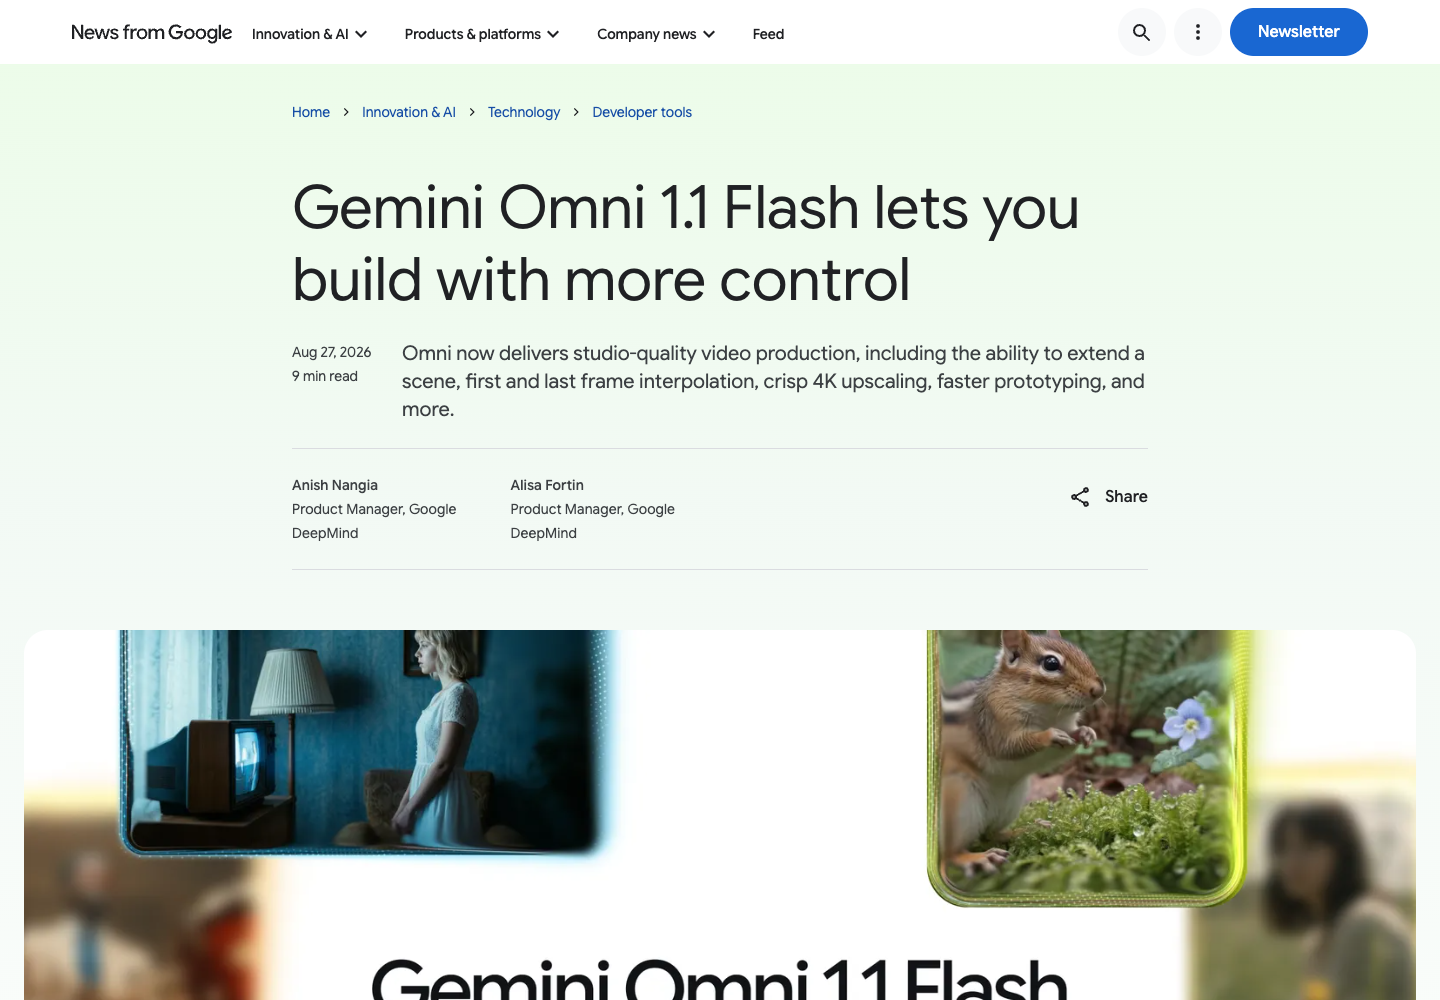
FIVE CHANGES AT ONCE
Gemini Omni 1.1 Flash 同时加入场景延展、首尾帧、360p 草稿、视频参考与 1080p / 4K 放大。
这些功能分处不同环节,却指向同一件事:先把动作和结构定下来,再逐步增加质量。生成视频开始有了粗剪、精修和交付的层次。
官方发布 ↗
KEEP THE SCENE MOVING
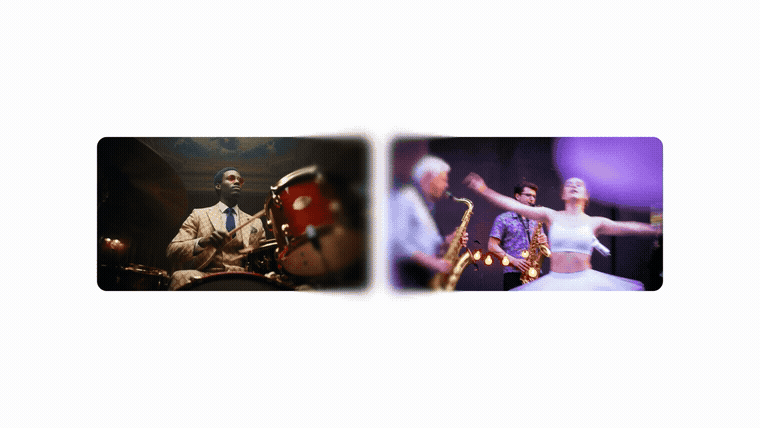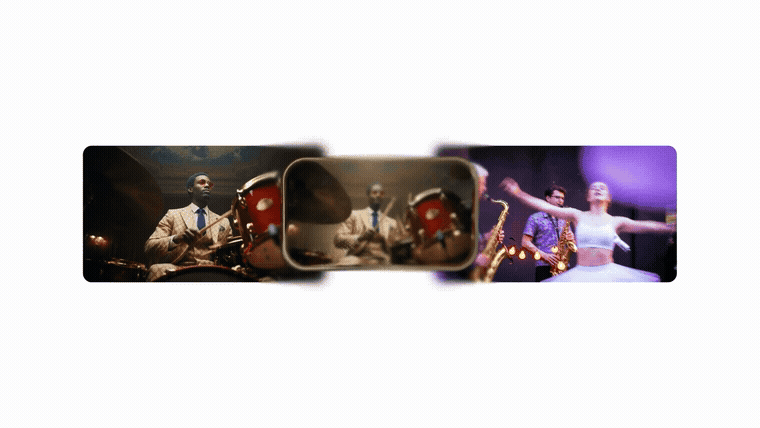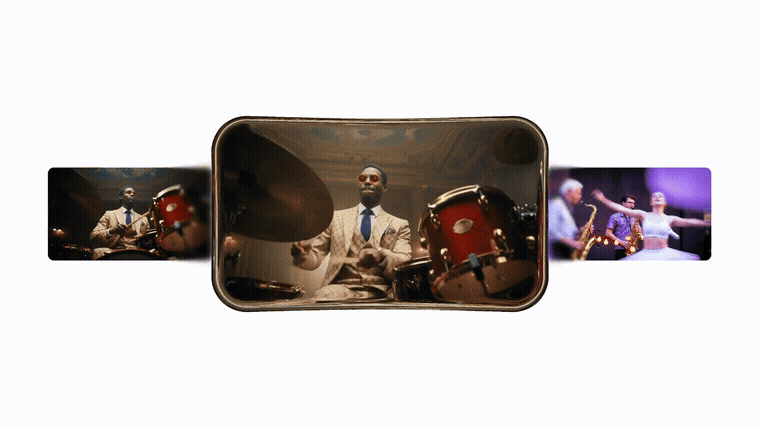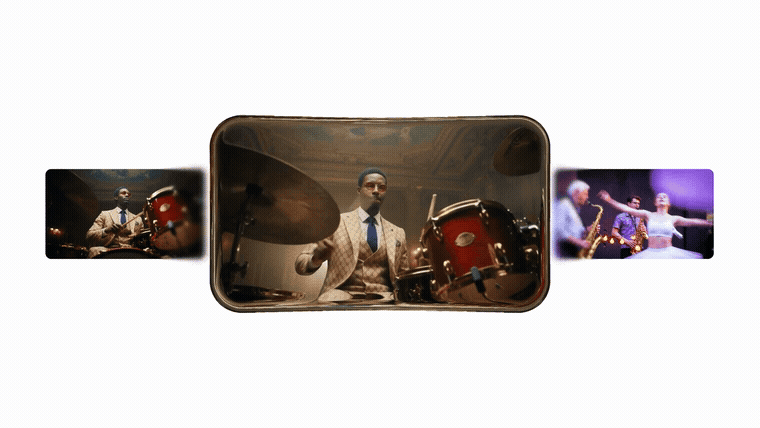
新版本会读取前一段最多十秒的上下文,再续出下一段十秒。官方给出的累计上限是四十秒。
延展最适合保持同一动作和空间。它并不保证长片级人物稳定;每次续接都应检查脸、服装、物件位置和声音边界。
FIRST FRAME / LAST FRAME
首尾帧让创作者指定起点和终点,中间运动由模型补完。它适合转场、变形、镜头连接和产品展示。
好用的关键是两张图之间要有可解释的路径。人物姿态和镜位相差太远,模型会用突变或遮挡把问题藏起来。
查看完整演示 ↗
CHEAPER QUESTIONS
Google 称 360p 草稿最多可快 60%,成本约为 720p 的三分之一。它适合先判断动作、镜位和节奏。
这些答案确定后,再做高清版本,钱花在已经入选的镜头上。
草稿模式说明 ↗
INPUT / OUTPUT
新版本可读取最长三秒的视频参考,并支持把结果放大到 1080p 或 4K。参考视频适合传递运动、节拍和镜头习惯;角色授权仍要单独解决。
A SMALL PRODUCTION LOOP
用三秒动作或首尾帧说明运动方向。
只看动作、景别、节奏和可剪性。
保存提示词、种子、参考和入选版本。
每十秒验一次人物、空间和声音。
只有批准镜头进入 1080p 或 4K。
POST-TRAINED FOR SPEED
fal 8 月 27 日发布 H3 Max。它基于 MiniMax H3 做后训练,重点是缩短等待时间,同时维持可用画质。
公司称,五秒视频可在三秒内生成,吞吐量约为官方端点的三十五倍。硬件、并发和测试样本来自 fal,外部团队仍需用自己的任务复测。
fal 官方发布 ↗
FASTER THAN PLAYBACK
官方示例把推理时间写在页面上。速度足以让人边看边改,也足以支撑现场演示和快速分镜。
端点时间不包括人的思考、上传、排队、下载和后期。制作总时长不会自动缩成三秒,最慢的环节会换位置。
模型端点与示例 ↗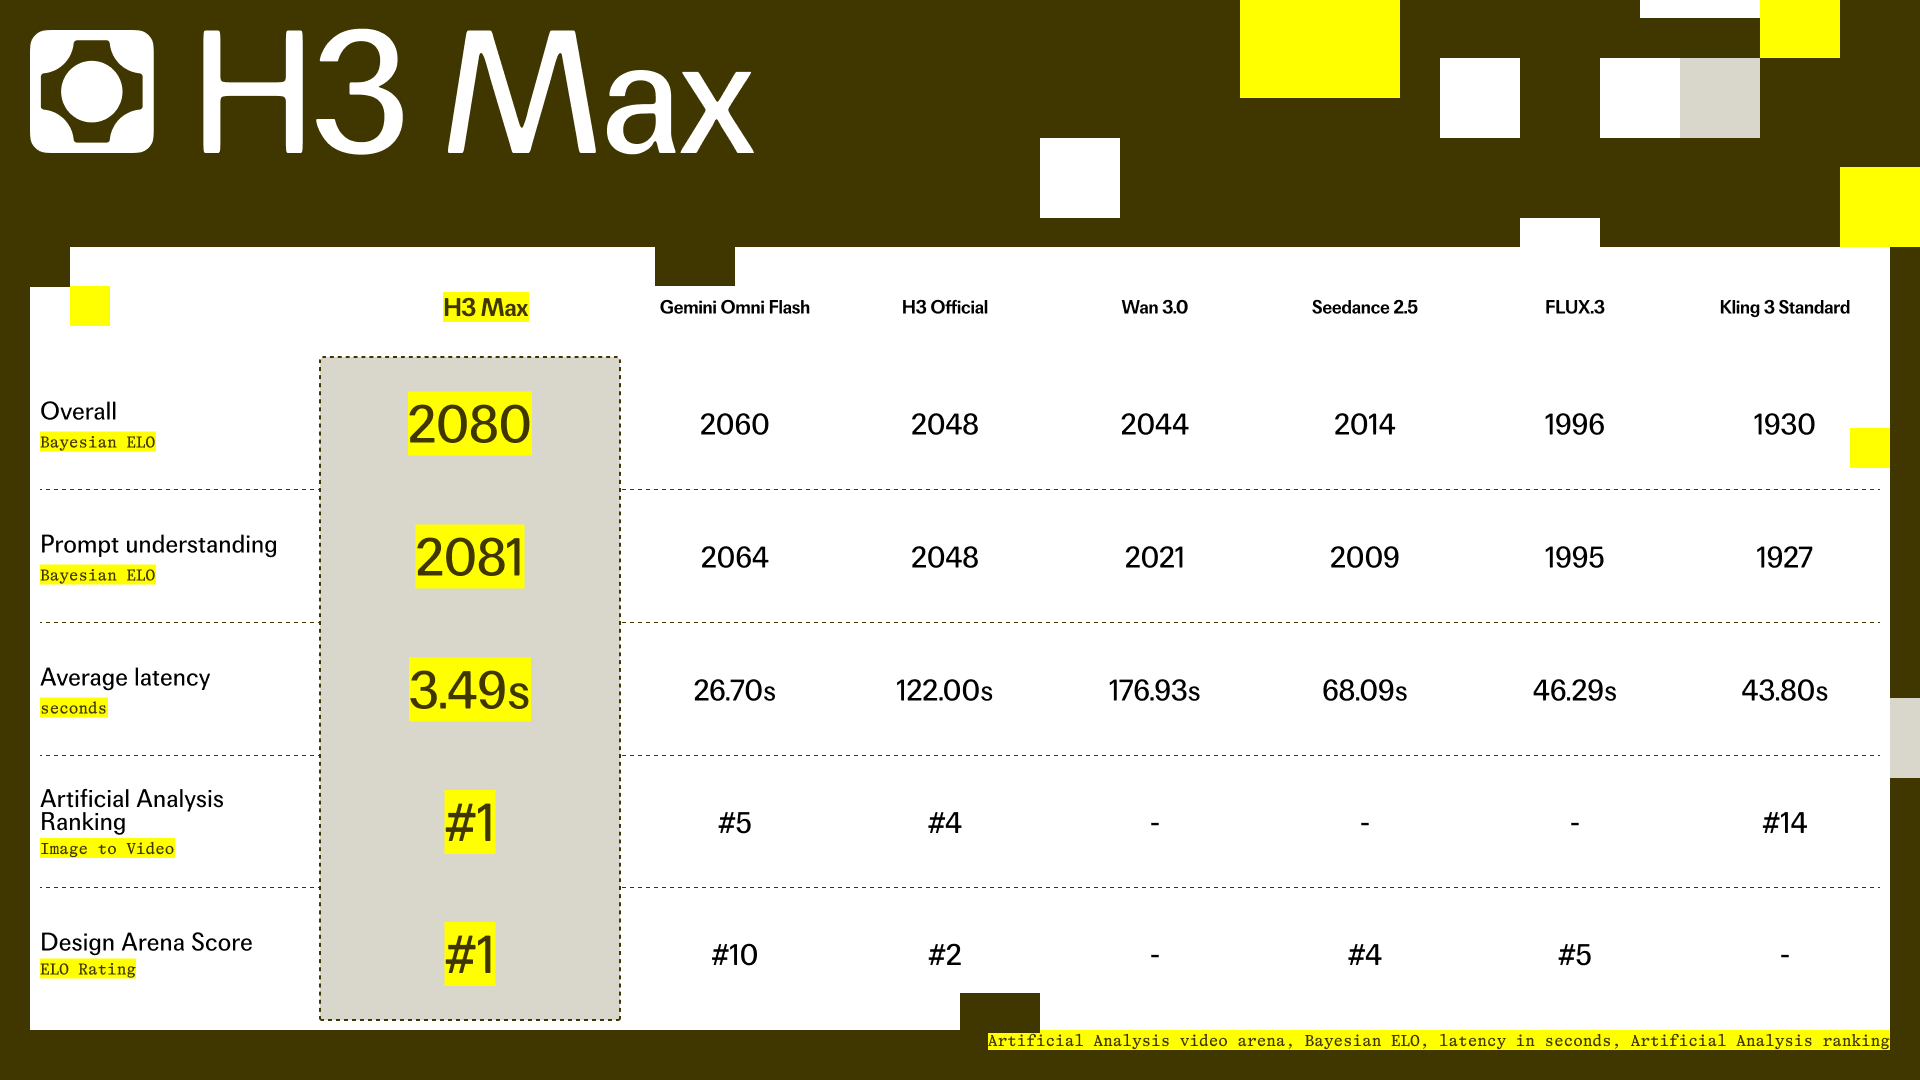
THE ASTERISK PAGE
fal 表示 H3 Max 在其内部人类偏好评测中排第一。这个结果能说明团队做过质量比较,不能替代独立盲测。
速度可以直接计时,审美判断需要更透明的样本和方法。
测试图与说明 ↗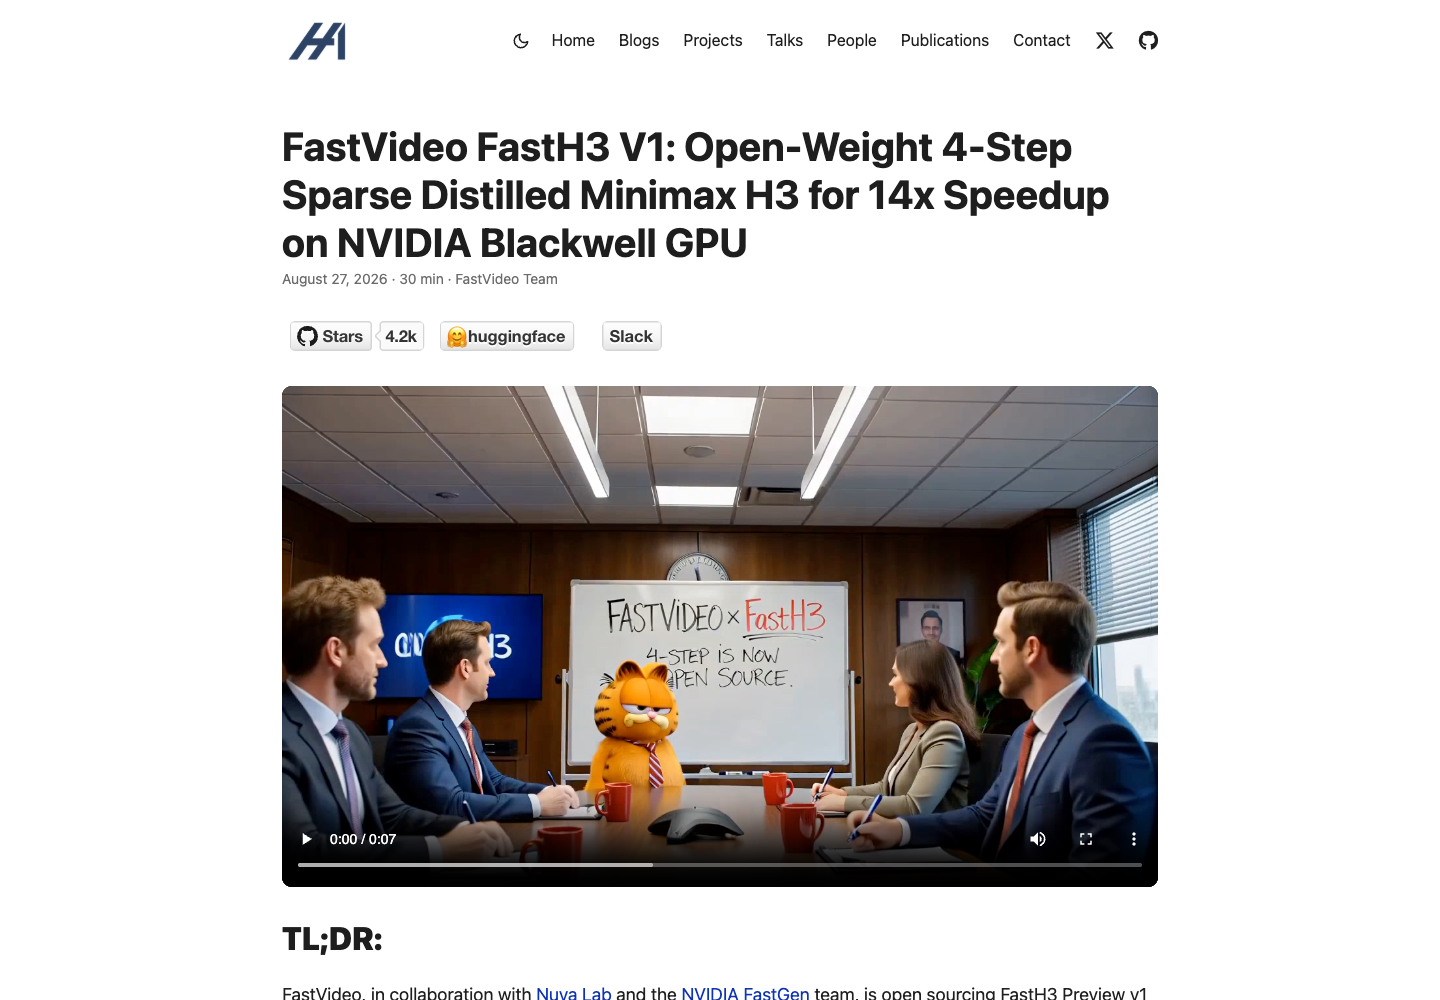
FOUR STEPS, OPEN WEIGHTS
Hao AI Lab 同日发布 FastH3 Preview v1:四步稀疏蒸馏,开放权重、LoRA 与推理代码。
官方称,八张 B200 可在十三秒内生成十五秒 768p 视频;单张 Blackwell GPU 最高约十四倍加速。Preview v1 目前只支持文生音画,参考图和参考视频仍在计划中。
项目说明 ↗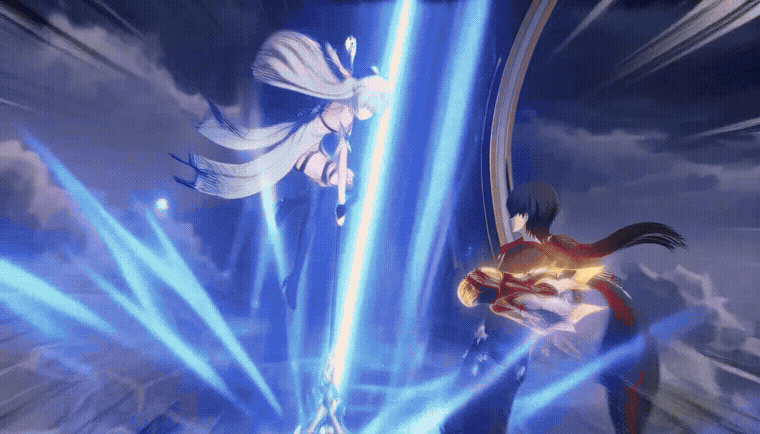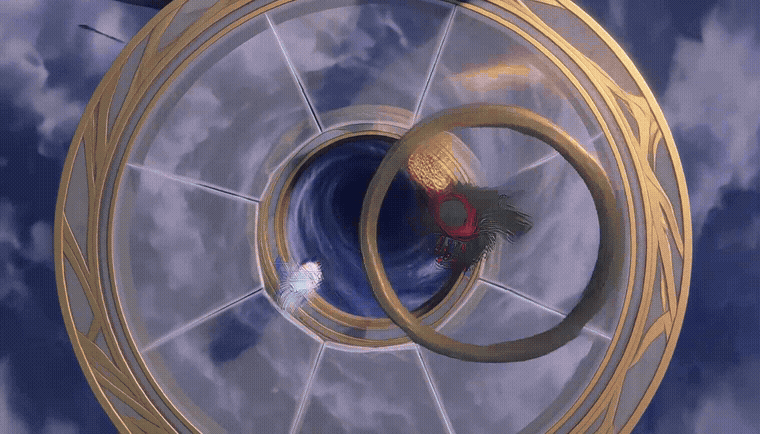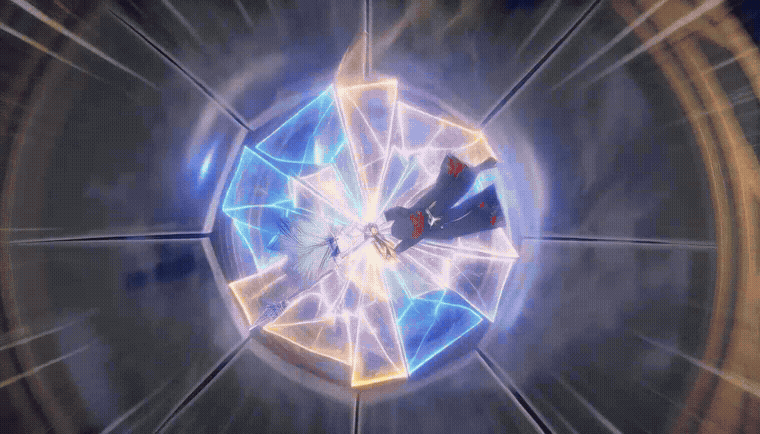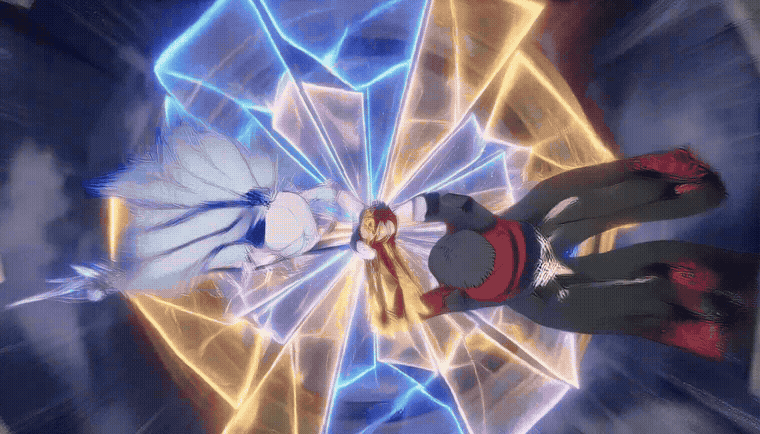
THE OPEN SAMPLE
样片里,动作节奏和镜头推进很顺。快速模型最容易暴露的问题也在同一处:高速运动中的肢体、武器和背景线条。
开源权重的价值在于可以复测。团队能用自己的角色、动作和硬件建立样本,而不只看发布页选出来的片段。
代码与权重入口 ↗WHAT IS HERE / WHAT IS NEXT
数字只描述指定硬件和官方样本。不同显卡、分辨率、时长与节点会改变结果。
路线图与测试条件 ↗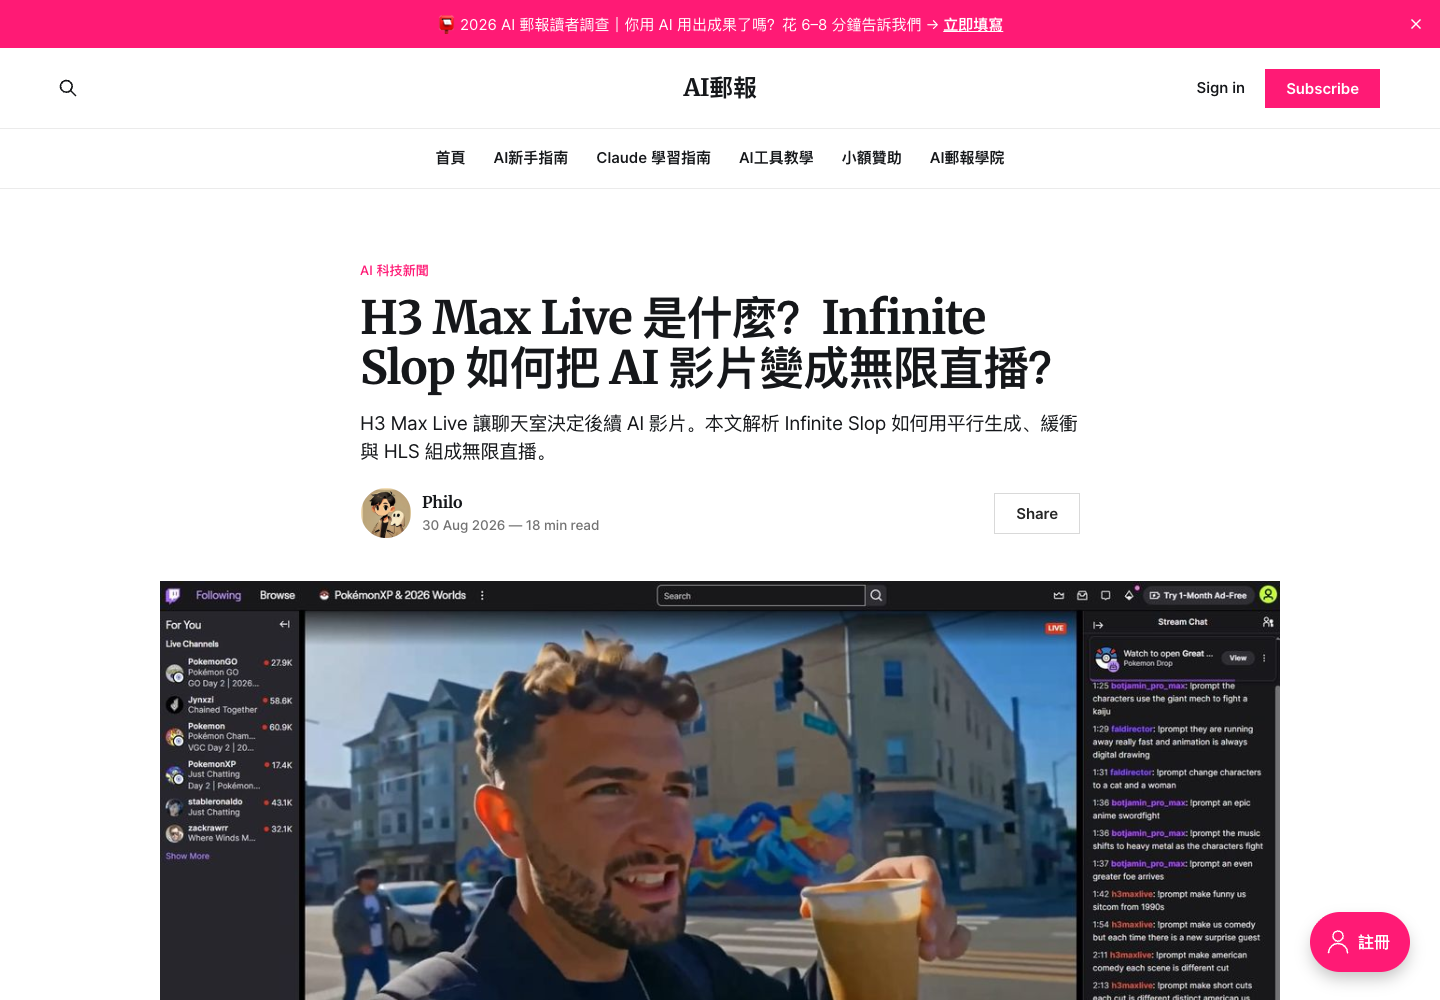
CHAT DIRECTS THE NEXT SCENE
fal 在公开直播实验中让聊天输入 `!prompt`,模型据此生成下一段画面。直播可以持续下去,叙事由观众轮流推动。
它目前停留在公开实验阶段,距离稳定制作服务还有很远。重复、失控、内容安全和故事断裂都很明显,却让“实时生成频道”第一次有了可观看的形状。
fal 公告 ↗THE LIVE QUESTION
生成快过播放以后,直播、游戏、虚拟人和互动剧都能把反馈塞进下一段画面。
先给世界边界,再从观众输入里挑选可继续的方向。
系统要判断哪些提示能接住上一镜,哪些会毁掉人物和空间。
直播没有几小时后的人工补救,输入过滤和画面审查要在几秒内完成。
没有角色状态和前情,快速生成只会得到连续的随机场面。
A LEADERBOARD SNAPSHOT
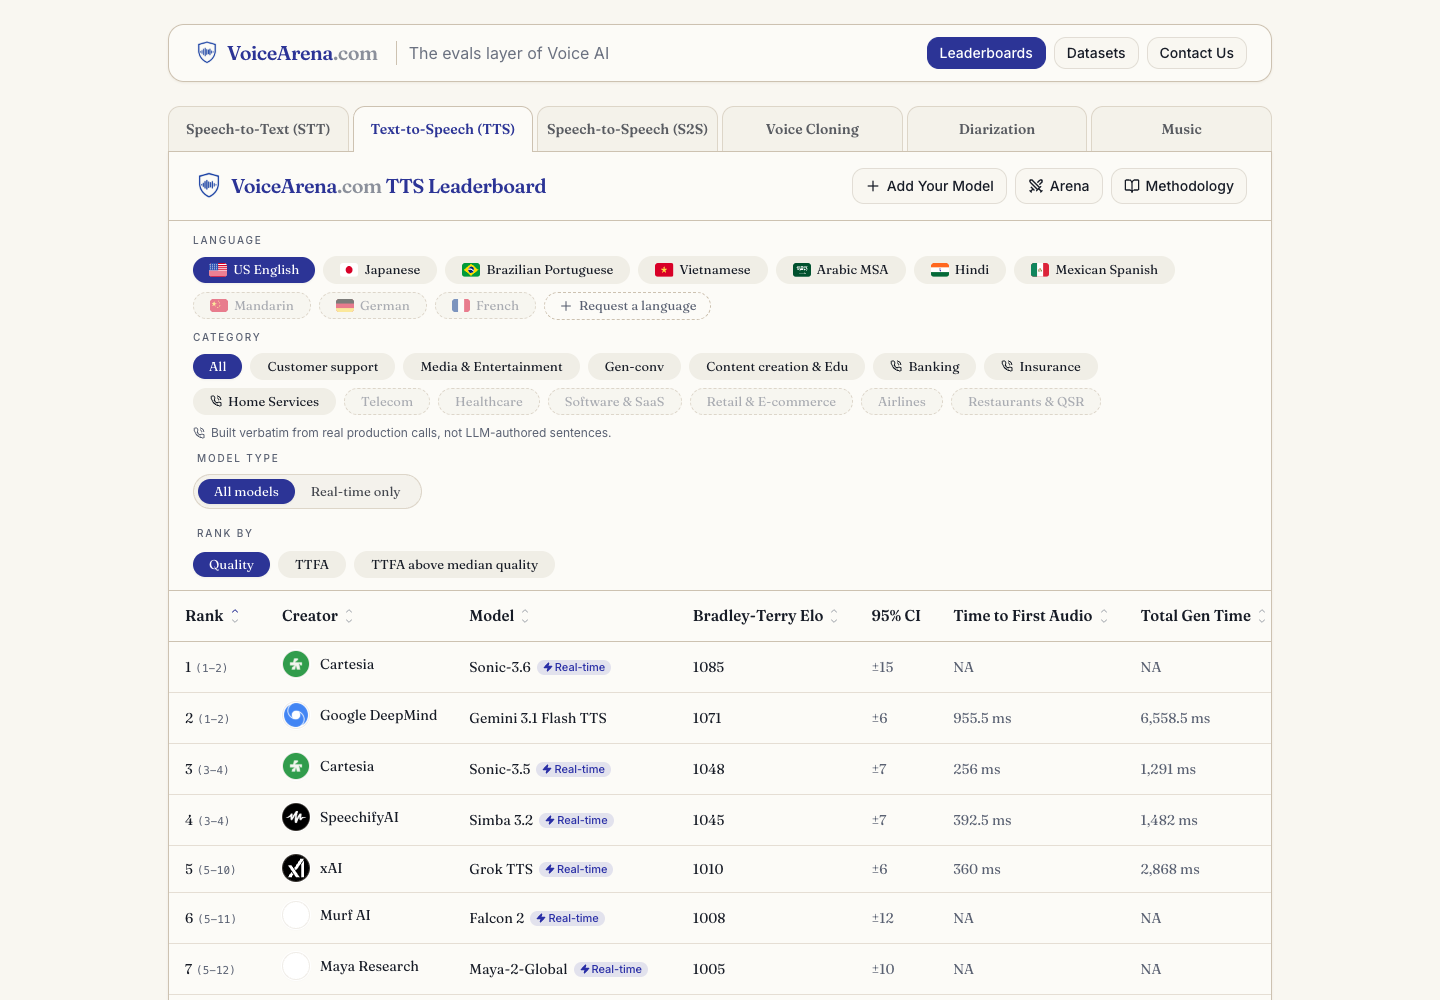
Voice Arena 的美式英语榜单给 Sonic 3.6 约 1085 Elo,与 Gemini 的领先模型在统计区间内接近。Artificial Analysis 的受控测试也把它列在前排。
排行榜每天会变,样本语言和评分人群也会影响结果。选声音时,角色年龄、语气稳定与长句耐听,比一张总榜更重要。
GENERATE → MEASURE → REPAIR
HeyGen 的视频播客把主持人与嘉宾的发言逐段渲染。问题随之出现:时间漂移、响度不一、视角跳动和表情断裂。
团队给出的办法很朴素:先生成,再测量;超出阈值就修,合格才接受。连续性从一句提示词,变成一组可检查的条件。
阅读工程报告 ↗TIME IS THE MASTER
画面剪点只能落在固定帧格上。
团队加入停顿对齐后再修正。
主持约 -15 LUFS,嘉宾一度低至 -29 LUFS。
先定音频时长和停顿。
把视频边界吸附到帧格。
响度统一后再合成。
超差片段单独返修。
THE ACCEPTANCE GATE
HeyGen 用共享场景生成远景和近景,再把通过审核的预览锁成固定快照。后续渲染只读取这个版本。
生成角色、声音与镜头
时长、帧格、响度、视角
通过阈值,锁定快照
只返修失败的局部
LICENSED CHARACTERS, LIVE CONVERSATION
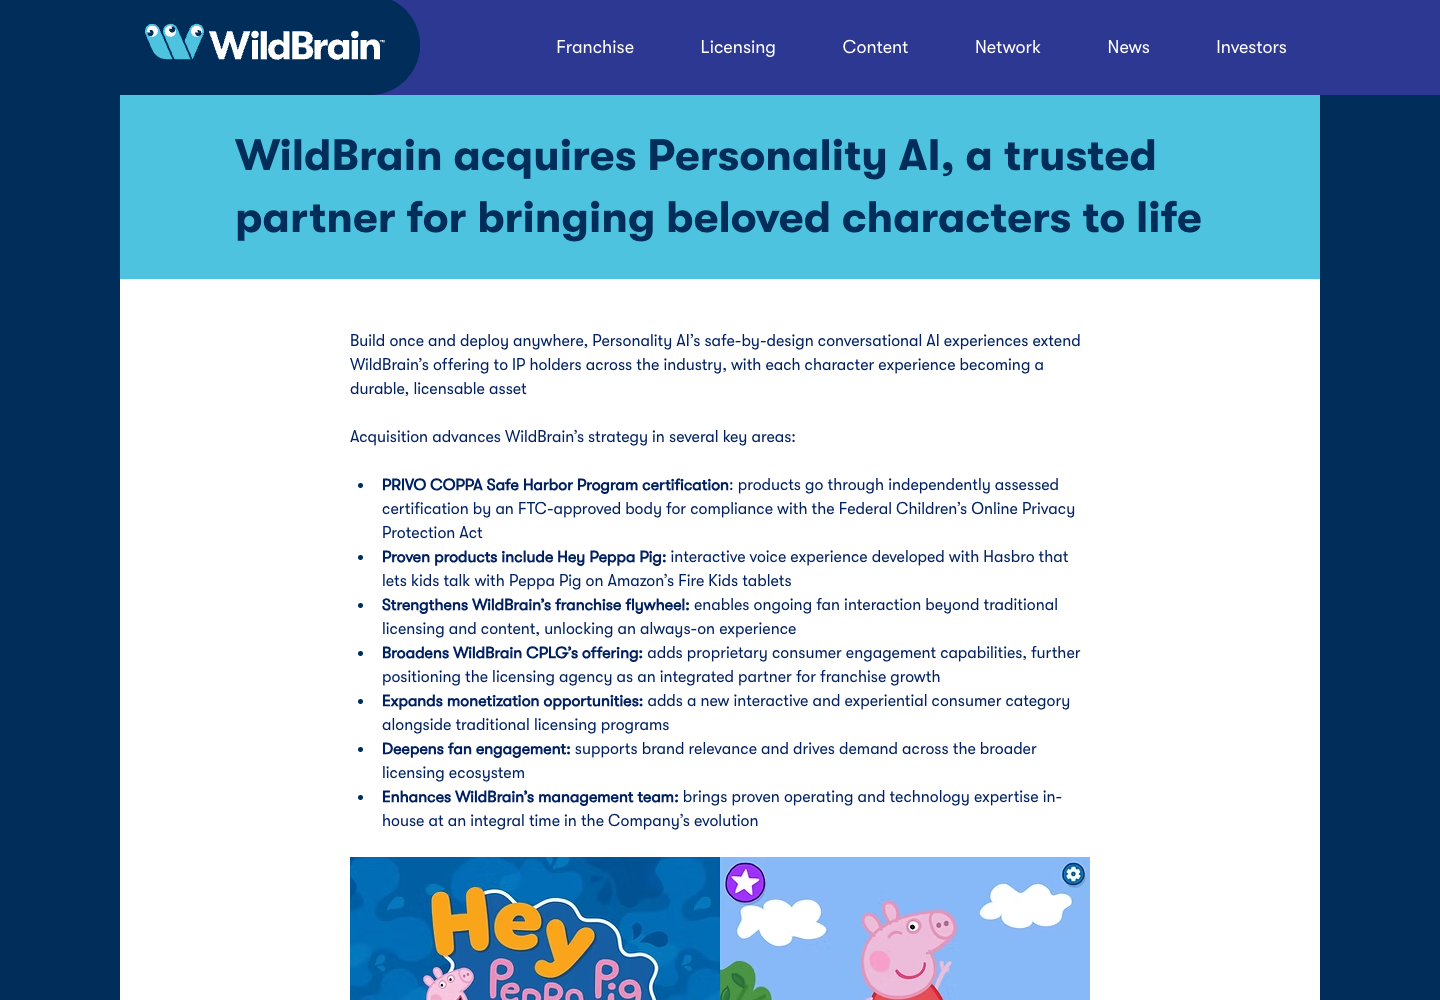
WildBrain 以现金与股票收购 Personality AI,后者为授权角色提供面向儿童的实时对话体验。
这笔交易把角色版权、语音、对话模型和家庭设备接在一起。公司列出的现有案例包括 Amazon Fire Kids 上的 Hey Peppa Pig。
公司公告 ↗THE DEAL
WildBrain 公布的结构包括现金、股票、周年款与业绩对价。最高金额并不等于当天成交价。
公司称产品通过 PRIVO COPPA Safe Harbor,并不储存或变现儿童个人身份信息和声音记录;这些为公司披露,后续仍需看实际执行。
交易与安全说明 ↗
THE AUDIENCE ASKS HOW
TheWrap 报道,Hank Green 因一句措辞引发观众猜疑。他承认用 AI 做研究,否认用 AI 写脚本,随后放慢频道更新并公开新的使用规则。
CreatorIQ 调研里,AI 更常用于脑暴、写作和编辑,直接生成视觉内容的比例低得多。工具用在哪里,正在成为观众判断作品的背景。
TheWrap 报道 ↗
COMPLIANCE ≠ ACCURACY
KQED 检查加州 SB 942 要求的 AI 内容检测入口,发现公司是否提供工具、工具是否易找、结果是否可靠,是三件不同的事。
检测器更适合提供线索,不适合独自给作品定罪。发布方保存来源、导出记录和编辑说明,往往比事后猜测像素更可靠。
KQED 调查 ↗PUBLISH WITH A RECEIPT
四行具体说明,通常比一句“AI 辅助”更有用。
人工撰写、机器整理,或两者如何分工。
实拍、生成、合成、修图分别到哪一步。
真人录制、授权克隆、合成语音或混合。
涉及真人、角色 IP、音乐和参考素材时写清。
THE FIELD / 05
本周样本里,先给结果、再说方法的短片,比站着念稿的 AI 主播更容易留下人。Lightreel 样本报告 ↗
SHOW THE PAYOFF EARLY
Lightreel 对 8 月中旬一批高互动 AI UGC 的观察,反复出现四类内容:结果先行的教程、无法实拍的产品画面、情境喜剧和有实际互动的虚拟角色。
这组选样无法代表整个平台。它更像一个创意雷达:告诉人们近期哪些格式值得继续试。
样本与方法 ↗
SAME TOOL, DIFFERENT RHYTHM
前提明确、冲突快、反差大,角色可以粗粝一点。
结果清楚、画面完整、步骤可收藏,产品感更重。
两边都不太奖励静止的 AI 主播念稿。角色需要拿起东西、移动、失败或改变环境,画面才像事件。
完整观察 ↗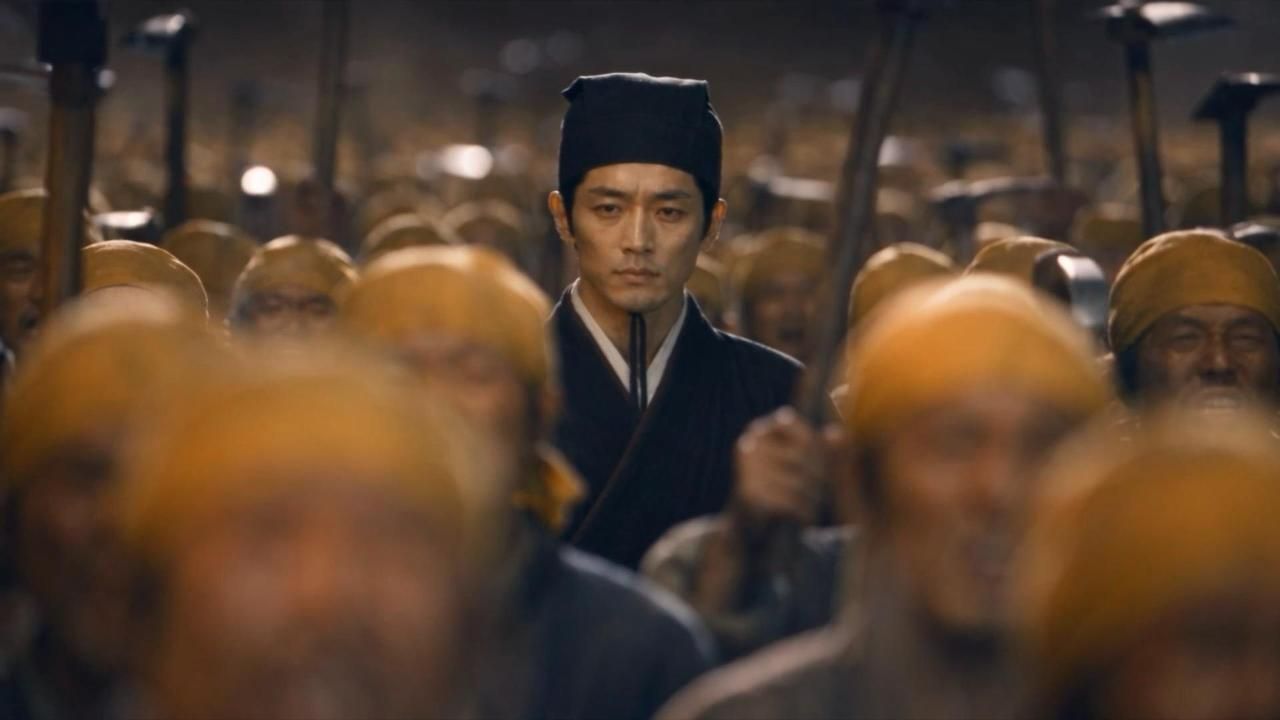
THE WORK TRAVELS FARTHER
截至 8 月 31 日截稿,B 站公开接口显示约 1755 万播放、151 万点赞、131 万投币和 78 万收藏。
创作者在相关报道中提到 Seedance 2.5 与 GPT Image 2。让作品扩散的仍是熟悉的神怪母题、清楚的情绪和能被复述的句子。数字是热度快照,无法证明艺术质量或商业回报。
FIFTEEN MINUTES, SERIALIZED
Henry Daubrez 与 ODD KID 8 月 26 日上线《Junkyard King》第二章,时长约十五分钟。
项目保留了剧本、角色表、分镜、合成、剪辑和声音等传统工序。生成工具参与画面,作品的连续感来自反复维护的角色与世界。
BEFORE YOU POST
观众能不能立刻看懂眼前发生了什么。
人物有没有真的影响物体和环境。
音色、响度、停顿和口型是否属于同一个人。
下一镜是否接住了上一镜留下的状态。
角色、声音、音乐和参考素材能不能说明来处。
标题与平台格式是否服务作品,而非只写模型名。
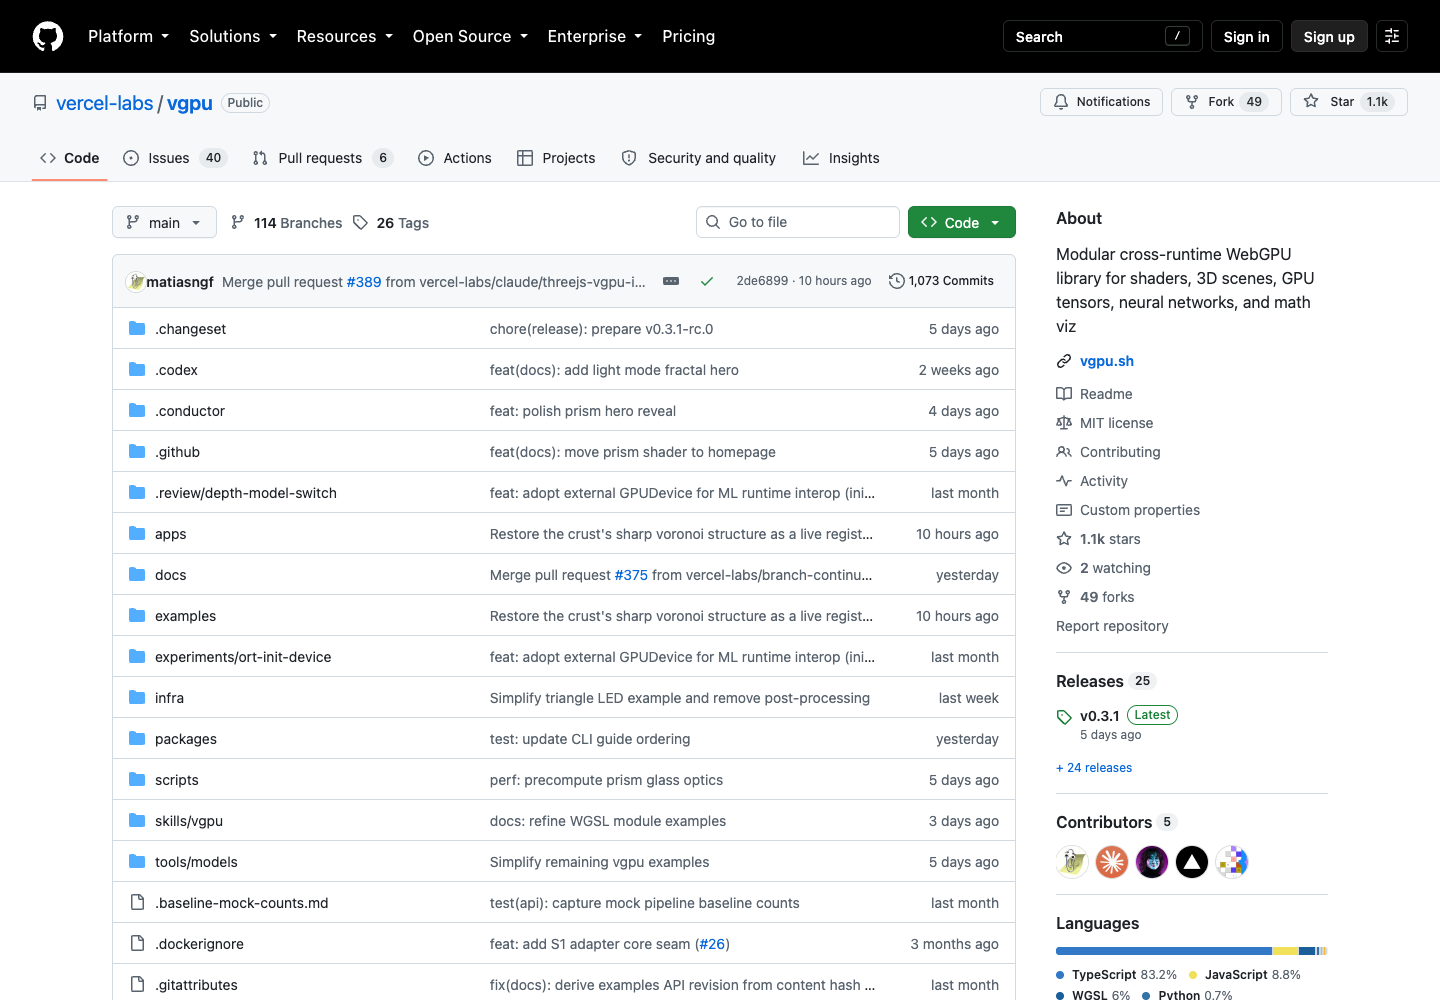
ONE TOOL WORTH KEEPING
Vercel Labs 开源的 vgpu 是一套模块化 WebGPU 工具。它把着色器、资源和计算任务整理成更容易组合的结构。
对影像团队,它更像底层积木:在线预览、实时滤镜、浏览器推理和交互式图形都可能用到。它不会替你完成影片,却能让网页端的视觉工具少写一些重复代码。
GitHub 仓库 ↗31 AUG → 06 SEP
FastH3 的本地实测会不会接近官方数字;更多参考模式是否按计划出现。
跟踪仓库 ↗三十秒长镜头需要多少次返工,决定单镜头预算能不能成立。
产品页 ↗Adobe、Figma、Runway 等合作入口会怎样安排参考素材与版本管理。
Google 说明 ↗H3 Max Live 若继续公开,最值得看的是它如何保存角色状态并拦住危险输入。
实验动态 ↗SOURCES / 24—30 AUG
以下为本期主要来源。公司性能数字均保留发布者口径;社区数据为截稿时快照。
完整引用、权利说明与补充报道保存在本期 references 目录。网页中的外部链接均可点击。
RAINWALKER NOTE
本周最有分量的变化落在速度。生成开始进入人的反应范围:看见、修改、比较,再看见。
这会让制作更轻,也会让轻率更便宜。人物散掉、声音失真、授权含糊、观众不信,都能随着速度一起放大。下一阶段的专业感,来自知道什么时候停、哪一版该留下、什么需要说明。